引言
预备知识
检索增强生成
检索增强生成 (RAG) 简单来说就是把检索的结果融入到大模型检索的上下文里这件事. 简单理解就是用户 query 作为一个检索器输入, 然后把检索模块的结果作为生成器的 context 丢进去. Vanilla RAG 的 pipeline 一般分成如下几个阶段:
- 预处理: 构建检索知识库. 依原始数据形态, 可选地做解析、分块, 最后入库建索引. 预处理的 pipeline 保证最后数据库里每条记录是 100-200 token 的 passage/chunk, 同时配备有例如 HNSW 索引的 dense vector 形态.
- 检索阶段: 类似推荐系统分为召回和可选的排序阶段. 根据索引类型执行相应的召回, 例如上面提到的稠密向量检索, query 和 passage 都在一个嵌入模型(Bi-encoder)编码下的语义空间, 召回时, 根据 embedding 的相似度来召回 topk 个结果, 然后可选地用重排器(通常是一个 cross-encoder)对召回结果重排序取更相关的 chunks.
- 生成阶段: 用检索阶段的结果来编排 prompt.
例如知乎的直答, 它就是把自家社区作为一个大的知识库, 来做 RAG 的. 大家常用的大模型产品里, 联网搜索就是把互联网作为外挂知识库, 提供大模型实时信息. 一些长期记忆的实现, 也依赖 RAG 的范式, 通过检索历史来召回记忆.
RAG 的优势在于无需持续微调 LLM 即可注入新知识,但局限也很明显:检索结果若缺乏多样性,会导致“知识坍缩”,生成倾向于重复最常见的观点,忽略边缘但关键的信息,尤其在多跳 QA、争议性话题或开放式查询中表现突出。
多样性”筛选”
在信息检索(IR)和推荐系统领域,多样性早已是经典优化目标。核心目标是:在保证相关性的同时,让结果集覆盖更多子主题、视角或信息粒度,避免“同质化”。
两大经典方法:
Maximal Marginal Relevance (MMR):迭代选择文档时,同时考虑相关性(与查询的相似度)和边缘相关性(与已选文档的差异度):
其中 超参控制相关性与多样性的权衡. 当然这里所有相关性都是依赖相似度函数计算的.
Determinantal Point Process (DPP):基于概率模型,通过相似度核矩阵的行列式(determinant)衡量整个集合的多样性。DPP 能全局优化集合质量(而非贪心迭代),在推荐系统中被广泛用于提升列表多样性,但计算复杂度较高(常需近似)。
前沿工作
检索端多样
SetR
RAG 检索阶段通常会根据相关性召回、重排最后得到 top-k 个片段. 但是对于复杂的多跳 QA 任务而言缺乏 information needs.
选 top-k 是依赖超参数的. 作为 stopping criteria 不够 smart, know when to stop 是检索阶段一个很重要的议题.
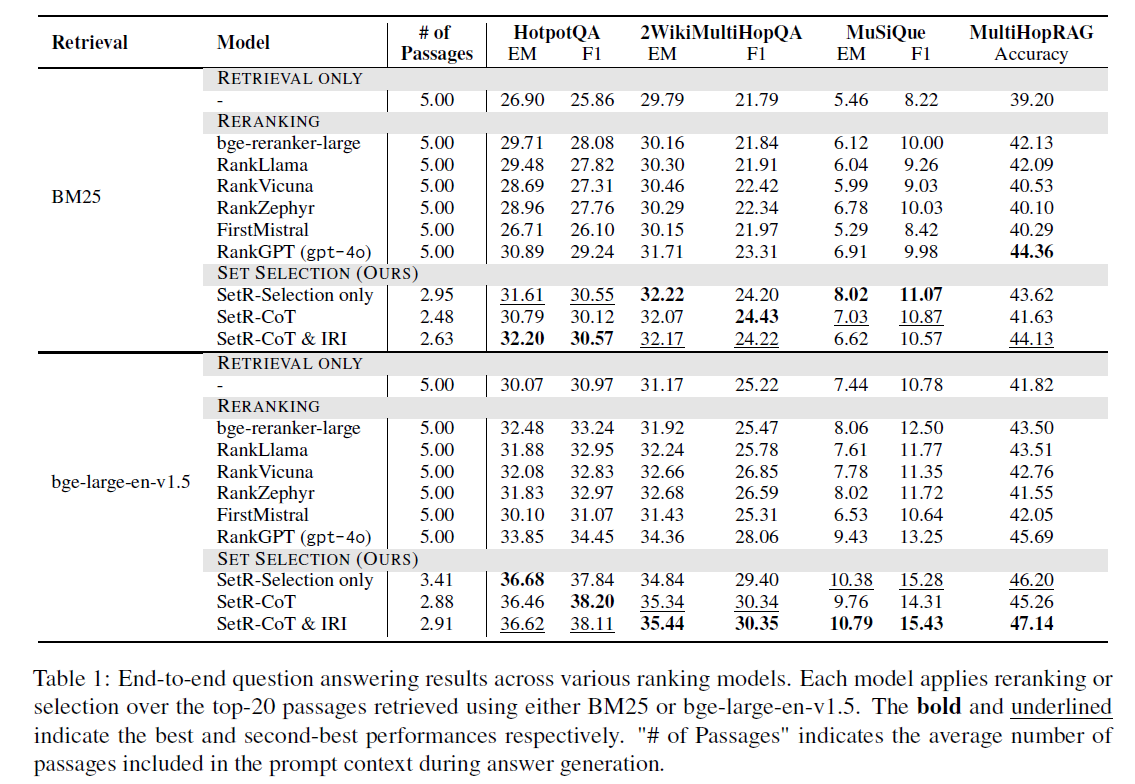
ACL Oral 这篇提出让大模型做召回结果的 subset selection.
I will provide you with {num} passages, each indicated by a numerical identifier []. Select the passages based on their relevance to the search query: {question}.
{context}
Search Query: {question}

Please follow the steps below:
Step 1. Please list up the information requirements to answer the query.
Step 2. for each requirement in Step 1, find the passages that has the information of the requirement.
Step 3. Choose the passages that mostly covers clear and diverse information to answer the query. Number of passages is unlimited. The format of final output should be ‘### Final Selection: [] []’, e.g., ### Final Selection: [2] [1].
提示词工程要求把 query 分解成几个关键的“信息子需求”、对每个子需求,指出哪些候选 passage 包含相关信息,最后综合选择一个子集. 为了让这个 CoT 稳定, 作者做了一步后训练微调,论文里记这个方法是 CoT & IRI: SFT LLM (基于生成 CoT 推理轨迹的),同时输出 selection 结果.
消融做的两种:
- Selection Only: SFT LLM, 直接用 QA 对做监督数据, 直接输出 selection 结果.
- CoT: 不微调, 让 LLM 做 CoT, 然后输出.
从论文会议时间倒推, 这篇 paper 应该是 25 年 3 月准备的.
后来做 Agentic RAG 启示从思路上来说都差不多: 召回时的 query 让 LLM 构造, 然后反馈的 loop 可以做成 inference-time 的(类似上面 CoT),也可以做成 ReAct 式的, 也可以做成多 Agent, 再外挂一个 evaluator. 而 fusion 的模块可以用上 IR 里面的一些经典方法.
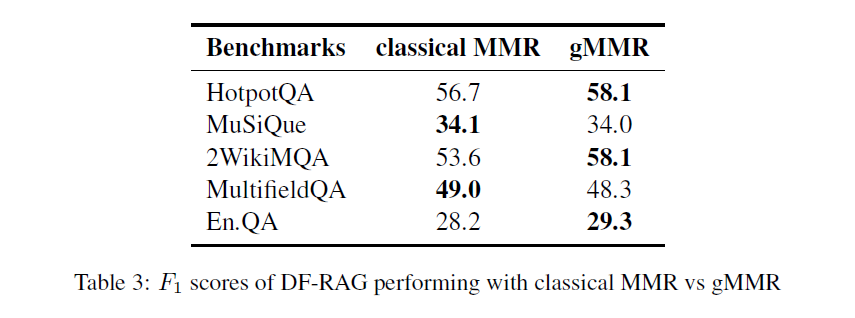
DF-RAG 这篇用的是一个 gMMR (geometric MMR) 的融合模块, 对标准 MMR 的与已选文档的差异度做了修正:
是集合 的质心:
直接看消融结果1:
生成端多样
参考文献
- (2025 Github) Diversity Aware Retrieval Augmented Generation (DARAG)
- (2025 EMNLP) RAG-Instruct: Boosting LLMs with Diverse Retrieval-Augmented Instructions
- (2025 Arxiv) Diversity Enhances an LLM’s Performance in RAG and Long-context Task
- (2025 ACL Oral) Shifting from Ranking to Set Selection for Retrieval Augmented Generation
- (2026 Arxiv) DF-RAG: Query-Aware Diversity for Retrieval-Augmented Generation
- (2026 Arxiv) DIVERGE: Diversity-Enhanced RAG for Open-Ended Information Seeking
Footnotes
-
我有理由怀疑是贡献点不足所以硬凑的. ↩