引言
让模型做到零样本或少样本分布外泛化, 如果能泛化到真实世界的所有任务上, 那这就是 AGI. 但很可惜, 无论什么算法还是模型,没有通解的银弹, 或者说 No Free Lunch: 为了泛化你必须对新任务表现出一定的偏好, 或者说是为了归纳而引入的偏差(Inductive Bias),这个偏差是人为引入的 assumptions.
合理的 bias 可以用更少的数据、更高效地得到最优解.
我们可以认为这种 bias 是在不同分布数据集上补充的 task-level pattern 先验. 好的 bias 可以弥补数据的不足, 所以称这种 bias 是变相的训练数据(training data in disguise), 从这个意义理解, bias 的优势在更大的数据集上会变得不明显.
RNN 觉得,序列是有时序依赖的,hidden state必须从h1算到h2再算到h3,序列存在结构先验,打乱顺序语义就变了;同时假设序列里的局部规律是不随位置变化的(time invarience), 在每个时间步用的是同一组参数1.
RNN 的 bias 一方面使得它在音频处理、流式翻译等需要长序列、短记忆的场景下表现优异, 另一方面导致它在长距离依赖会梯度消失,而且没法并行.
自注意力(self-attention, 也叫 intra-attention)放弃了序列之间局部性和时序性的先验,核心思想是:直接让每个token和所有token算相关性. 它假设任何 token 之间都可能有关系.
这个先验条件非常弱,所以这意味着运用了 attention 的模型需要更多数据才能训练好:后来scaling law也验证了这一点.
Transformer 之前 self-attention 已经有了,但都是作为 RNN/CNN 的辅助模块在用.
transformer 的核心贡献是第一个把 self-attention 拉到一个更高位置的架构, No CNN/RNN,它本身就能建模序列依赖关系, 所以 attention is all you need. 故事讲完了,从 idea 来看其实很廉价. 但, 不是前人想不到这么做,而是把它做好太难了.
我们看到 transformer 里的各种“小巧思”:多头注意力、QKV 的归一化、位置编码、decoder的causal mask……其实都是工程对 attention 的弱先验做补充. This is why it stands out.
预备知识
本文假设读者对大模型有一定的了解与使用. 这会帮助这篇文章更加 scoped.
Token / BPE Tokenizer
文本切成的“小块”就是 Token. 这些小块是模型真正处理的最小单位. 比如把一句话按词切,或者按字母切. 但你会发现直接用词切分,词表太大且无法处理生僻词;用单个字母又丢失了语义信息.
Tokenizer 负责构建一个词表,来把一个句子切分成一个个 (token, token_id) 对.
BPE (Byte Pair Encoding) 是一个分词算法, 它的做法是: 从单个字符开始,不断把出现次数最多的相邻两个字符,合并成一个新 Token,重复,直到词表大小够用. 它是目前的 LLM 普遍运用的分词算法.
Embedding
token 在喂给模型前需要有一个高维表征,就是 embedding vector.
token_id 作为索引,embedding 才是 LLM 理解 token 的 representation.
我们提到 attention 在架构层面放弃了时序性的先验,但是位置信息对于 NLP 任务来说又是极为重要的. 为了在丢给 attention block 处理前注入位置级信息,引入了所谓 positional embedding,直接加在 input embedding 上.
最经典的 sinusoidal positional encoding:
这里做的假设是:模型能够更好通过相对位置学习, 可以表示成 的线性函数. 记 :
写成矩阵形式,优雅之处就在这里——这是一个二维旋转矩阵,旋转角度只由偏移量 决定,与绝对位置 无关:
这给了后来 RoPE 直接的启发: 既然相对位置天然对应旋转,不如直接把这个旋转施加在 、 上,让内积 天然编码相对距离,而不是像 sinusoidal 那样靠加法把位置信息混进去.
Transformer
我们常听到一个 LLM 有着 xx B 的参数规模,那么这些参数都是怎么构成的?
naive transformer2 模型由 个相同的 Layer 组成,每个层分为两部分:self-attention 块和 MLP 块.
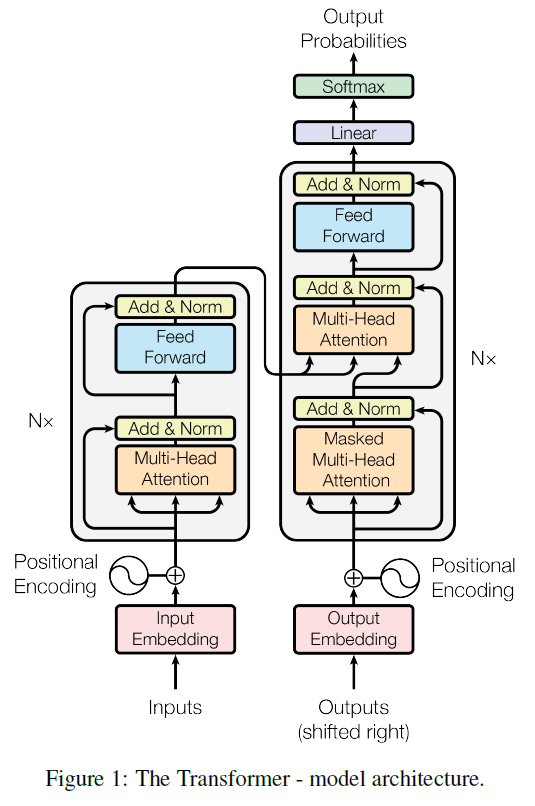
可训练模型参数量可用下面的公式估算3
- 是 hidden layer 或者说是 embedding size.
- 是词表大小.
这里模型参数占比最大的部分是平方项,这个平方项就是模型核心骨干,线性项是LN和残差组成的. 其中 Attention 的参数占 1/3.
Self-attention
Attention 假设 token 之间都存在关系,对于一个 3 个 token 组成的句子,就要计算一个 3x3 的关系矩阵. 那么衡量这个关系的分数要怎么算呢? 这里引入了三个权重矩阵:
- 其中 是注意力头的维度.
怎么理解 Q(Query)、K(Key)、V(Value)?第一次听到这个概念, 我最想问的就是这个和传统 sys 里的 K-V 什么关系.
拿我们最熟悉的 Redis(Remote dict Service),它的 kv 查询就是把 hashed 的 query key 放到一个 dict 里查询,query 和 key 要么 match 要么不 match;
def redis_get(q, kv_dict):
    return kv_dict[q] if q in kv_dict else None
之前提到,attention 在 transformer 提出前就出现了. 因为 RNN 会遗忘,所以有 Memory Network 的研究, 核心想法是给神经网络一个外部可读写的记忆模块. Attention 范式把 memory 做了 KV 分离,用 query 去跟 key 算相关性(注意力分数),然后拿这个权重去加权 value.
attention里的qkv是软匹配,query和所有key做点积算相似度,然后softmax加权求和所有value,是连续的。
举个例子:“鱼” 这个 token 会经过三个不同的投影矩阵,同时变成了q k v三个向量。作为query的时候,它在问”谁跟我有关”,可能会关注到”烤""好吃""海里”这些token;作为key的时候,它在等别人来匹配它,比如”猫”的query可能就会跟”鱼”的key算出很高的注意力分数,所以叫 self-attention 就是因为序列自己跟自己算注意力.
def attention(Q, K, V):
    scores = Q @ K.transpose(-2, -1) / math.sqrt(Q.size(-1))
    attn = F.softmax(scores, dim=-1)
    out = attn @ V
    return out
你会发现历史是个惊人的回环:从最初 RNN 外置的 attention memory,到 transformer 把外部记忆内化成了序列内部的 self-attention,但 context window 终究有限,不可能把所有知识都塞进参数里,虽然模型可以再叠 block 层,但很快会遇到 compute bound 的情形,所以又出现了检索增强生成(RAG)外挂知识库的做法,而最近的一些工作又试图在 attention 外来表达 memory,作为大模型的原生能力.4
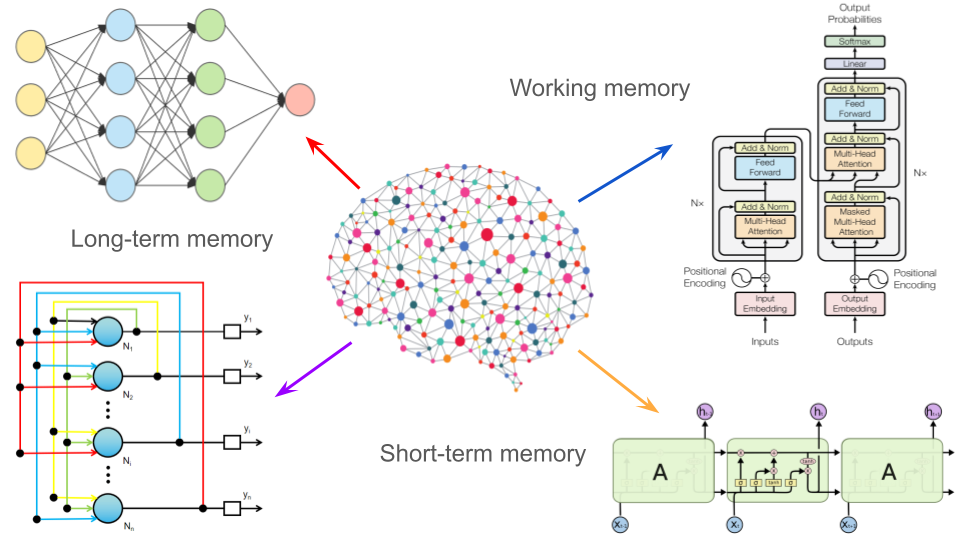
我们相信,在不久的将来, 非常有可能出现一个比 attention 表达能力更强的模型来做到这一点.
多头注意力 MHA
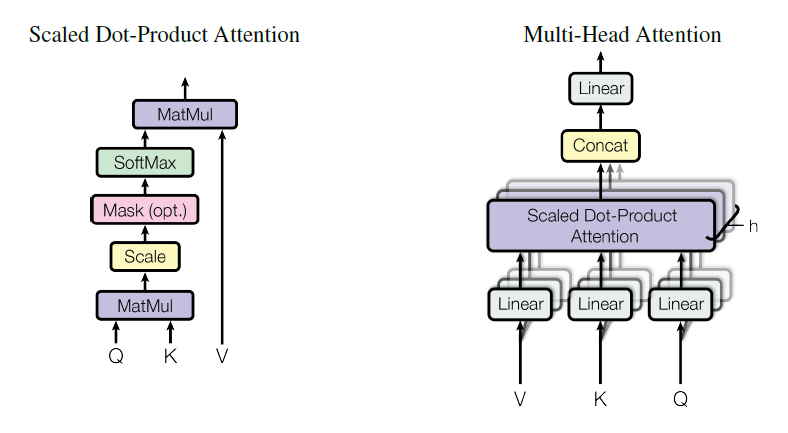
那么为什么这里要做 scale,以及为什么要拆解成 multi-head 呢.
前者大家应该都能猜到是为了 numerical stability:q 和 k 做点积,维度是 , 设 ,则点积 的方差为:
越大方差越大,值就越极端,丢进 softmax 之后就会出现一个接近 1 其他接近 0 的情况,梯度几乎为零. 除以 就是把方差拉回 1,让 softmax 的输入在一个比较温和的区间,梯度能正常流动。
多头注意力可以这么理解:众所周知 attention 要对语言建模,包含文法结构、语义关系、情感色彩等多个特征,如果你把所有维度塞到一个大head里,这些不同的pattern会互相干扰,因为 softmax 会把它们压成一个分布. 在一个高维语义空间里,它学到的 pattern,最后大概率是混杂的、不显著的.
所以这里做法和 CNN 的多通道卷积核——有的提取边缘,有的提取纹理,有的提取颜色,最后 Concat 起来,作为下一层的输入——是一致的.
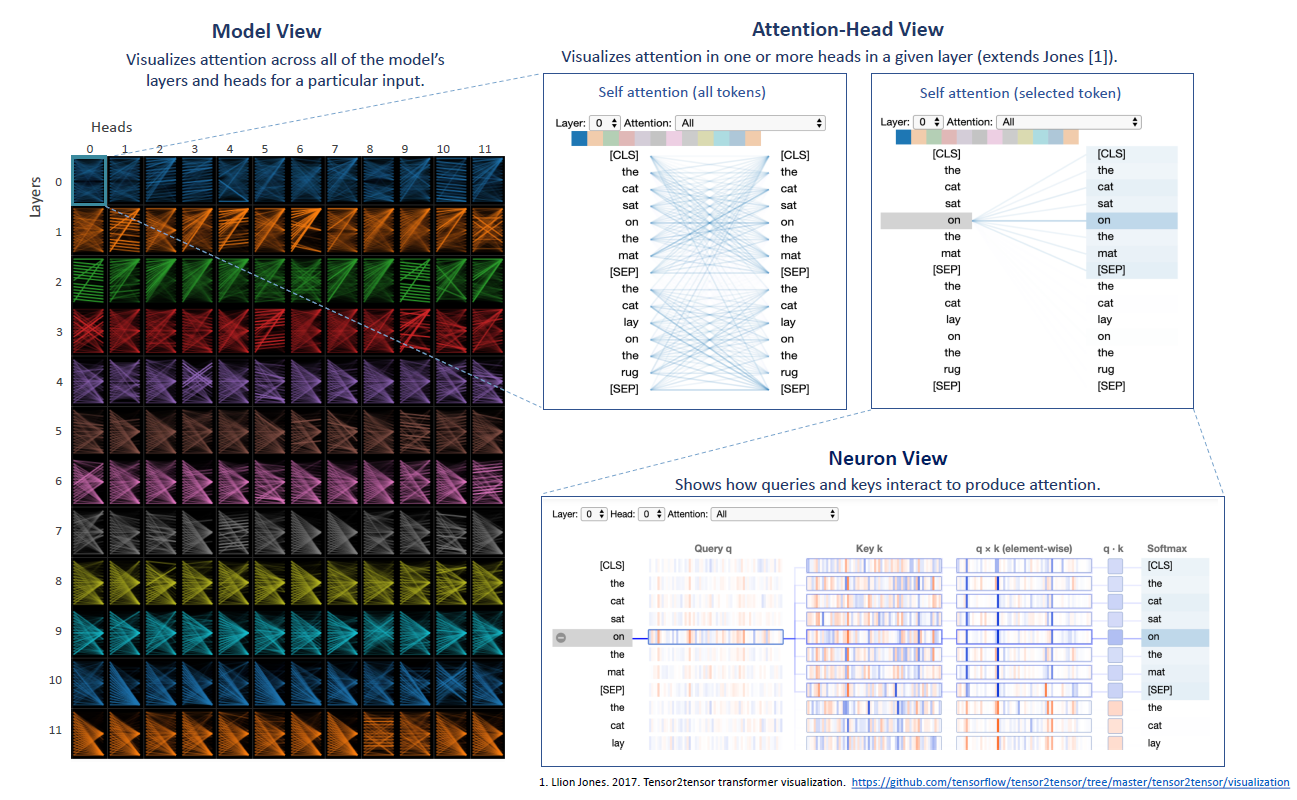
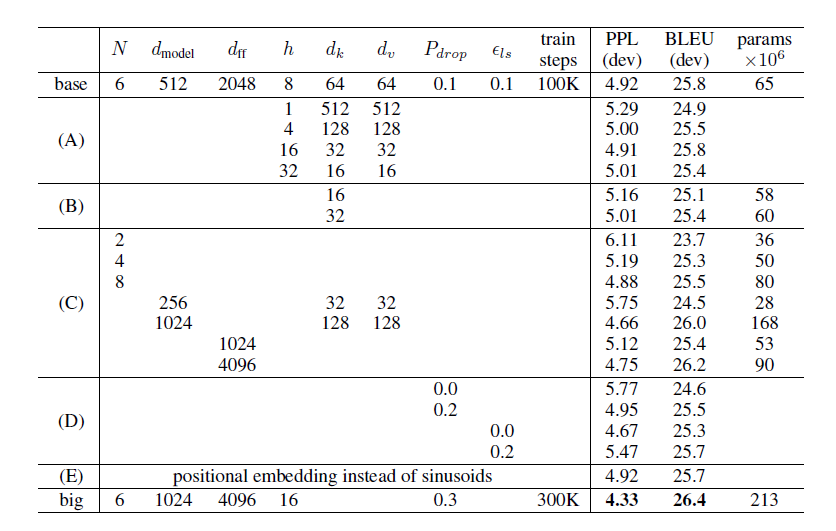
有非常多的可解释性工作关注 heads specialization: 因为我们其实很难去选定 head 的个数(这相应的决定了每个头的维度), 原论文也是通过 hyperparams sweep 得到的一个经验参数:
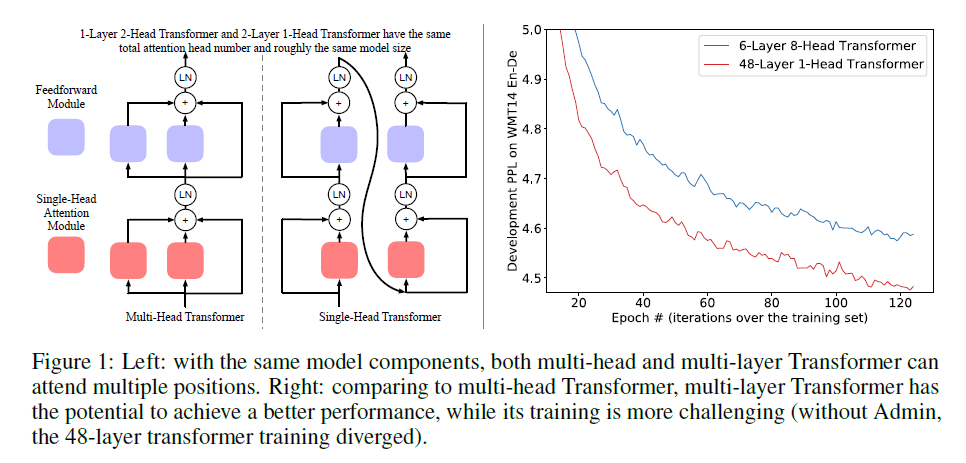
不过也有 paper 指出 Multiple subspaces 不是多头注意力的专属功能,你可以用一个足够深的 multi-layer single-head attention 来做等价. 从这个意义上说,多头的一大优势是它训练稳定性高.
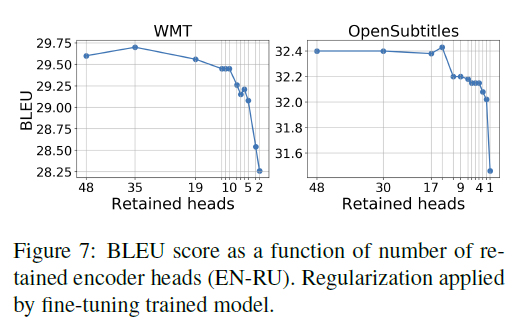
但结论是: 模型训练出来后,实际只需要少数 heads 就能接近满性能,但如果头数太少,性能就会剧烈下降.
如果你对每个头做 PCA,发现单个头不低秩,每个头好像都在认真学自己的东西;但所有头拼接后的有效交互空间极低秩,它们在 query-key 内积空间里关注的“模式”高度相似.

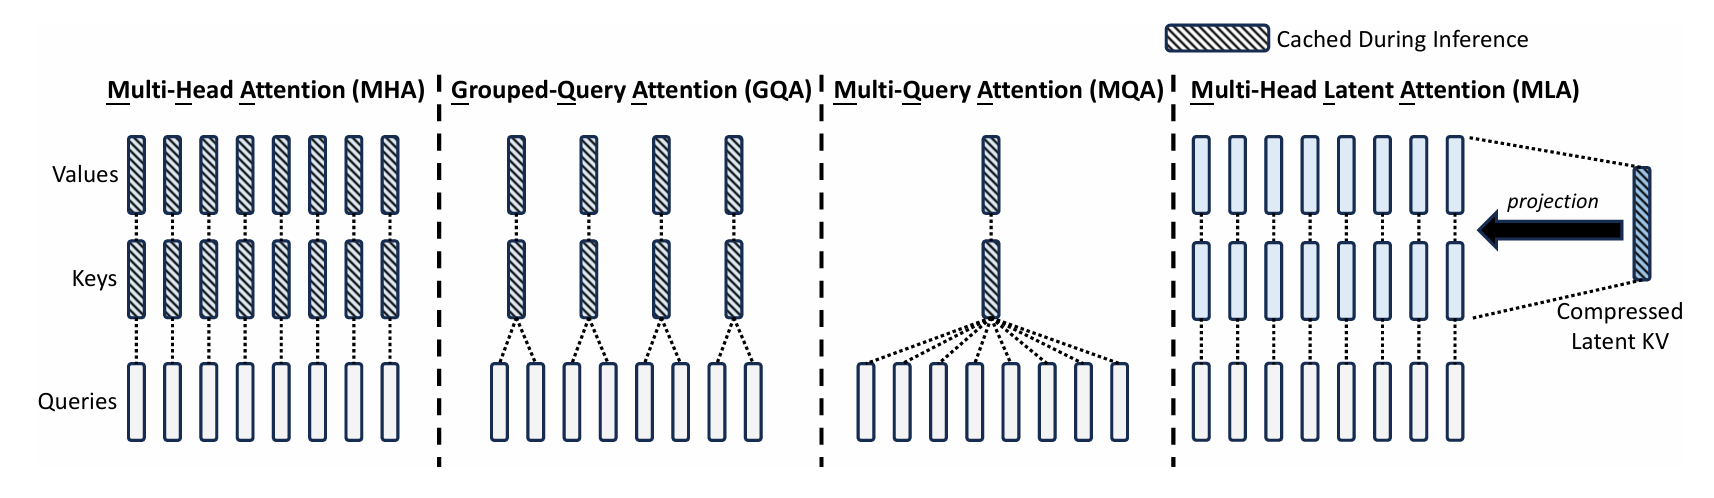
concat 的聚合方式还是太拍脑袋了, 所以在多头注意力这边应该有更细粒度的架构,例如 share 一部分权重提供所有 head 通用的能力. MQA(多查询注意力)和 GQA(Grouped Query Attention)就是在压缩head数量.
回到主线: LLM 到底咋 Predict Next Token?
attention block 的输出是一个 context-aware 的 token 表示. 那拿到这个表示之后,模型还要干什么?
原始的 transformer 论文里有 encoder 和 decoder 两个部分:encoder 负责把输入序列编码成一组 key-value,decoder 拿着这些 kv 做 cross-attention,再一步步生成输出. 这种结构在翻译任务上很自然——输入和输出语言是两个独立的序列.
cross-attention 和 self-attention 的计算方式完全一样,区别只是 来自 decoder 自己,、 来自 encoder 的输出:
但后来大家发现,encoder 其实没有必要. 没有必要单独为序列对齐去独立两个模块, 一个足够深的 decoder-only 模型,已经有能力在上下文里自己”编”出任何信息, 目前几乎所有主流 LLM 都是 decoder-only 的架构.
Decoder-only 模型做的事情极其简单粗暴: 给定前文,预测下一个 token.
把一段文本的联合概率分解成一系列条件概率的乘积,这就是自回归(autoregressive). 模型每次只往前看,不能偷看未来,训练和推理的目标是一致的.
训练时,最后一层 attention block 的输出过一个线性层,得到每个位置对应词表的 logit,再 softmax 成概率分布,与真实的下一个 token 算交叉熵 loss.
推理时,就是不断采样 next token 然后把它拼回序列继续生成,直到采样出 <eos>.
masked self-attention
推理时需要一个 token 一个 token 地生成,没有办法并行——因为第 步的输入依赖第 步的输出,这是自回归的本质代价.
训练时完全不同. 训练的目标序列是已知的,比如我们知道答案是 Adam is an optimizer,就可以构造一批监督信号:
| 输入上文 | 期望预测 |
|---|---|
<bos>Q: Who is Adam?<eos> | Adam |
<bos>... Adam | is |
<bos>... Adam is | an |
<bos>... Adam is an | optimizer |
朴素做法是把这四条分别跑四次前向,但这太浪费了. 注意到这四条输入其实是同一个序列的不同前缀——整个序列只需要跑一次前向,在 attention 里加一个约束:位置 只能看到 的位置,就等价于同时算完了所有前缀的预测.
这个约束就是 causal mask:在计算注意力分数之后、softmax 之前,把上三角(未来位置)全部置为 :
softmax 之后 变成 0,每个位置的 attention 权重天然只分配给自己和左边的 token. 一次前向就得到了序列所有位置的 logit,对应位置的 cross-entropy loss 加起来一起反传.
这个训练技巧叫 teacher forcing:用 ground truth 序列作为输入(而不是模型自己上一步的预测),配合 causal mask 做到并行.
推理时没有 ground truth 可用,就只能一步步 autoregressive 地采样了——这也是训练和推理之间存在 exposure bias 的根源.
KV Cache
推理时每生成一个新 token,都要对整个上下文跑一次 attention. 第 步时序列长度是 ,计算量是 ,生成 个 token 总计算量是 ——这显然撑不住长序列.
但注意 causal mask 的性质:历史 token 的 、 永远不会被未来改变. 位置 的 ,只依赖于 ,只要输入序列不变, 和 就是常数.
所以推理时可以把每一步算出的 、 缓存下来,下一步只需要算新 token 的 、、,然后把 、 追加到缓存,用 去跟完整的 做 attention:
这样每一步的计算量从 降到 ,总计算量从 降到 . 代价是显存:KV Cache 的大小是 ,长上下文时显存压力很大,GQA/MQA 压缩 head 数量在推理侧的核心动机也在这里.
Efficient Attention
Self-attention 的计算复杂度是 ,显存是 ——序列长度翻倍,计算量翻四倍,显存翻四倍. 这是 attention 最大的工程瓶颈.
两条路线来解决这个问题.
近似 attention:改变 attention 的数学,用稀疏或低秩近似换掉完整的 矩阵. Linformer 把 、 投影到低秩空间,把复杂度压到 ;BigBird 只让每个 token attend 到局部窗口 + 少量全局 token,复杂度降到 . 但近似必然有精度损失,实践中效果参差不齐.
精确 attention + IO 优化:FlashAttention 不改数学,改的是 GPU 内存访问模式. 传统实现里 的注意力矩阵要先写进 HBM(显存),再读出来做 softmax,HBM 带宽是瓶颈. FlashAttention 用 tiling 把计算分块,全程在 SRAM(片上高速缓存)里完成,避免了 HBM 的大量读写. 数学结果完全一致,但实际速度快 2–4x,显存从 降到 .
prefill and decode
参考
- (NeurIPS 2017) Attention Is All You Need
- (ICML 2020) Linformer: Self-Attention with Linear Complexity
- (NeurIPS 2020) Big Bird: Transformers for Longer Sequences
- (Neurocomputing 2021) RoFormer: Enhanced Transformer with Rotary Position Embedding
- (NeurIPS 2022) FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness
- (COLM 2024) Mamba: Linear-Time Sequence Modeling with Selective State Spaces
- (ICLR 2024) FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning
- (Deepseek 2025) DeepSeek-V3.2: Pushing the Frontier of Open Large Language Models
- (Moonshot AI 2025) Kimi Linear: An Expressive, Efficient Attention Architecture
- (Moonshot AI 2026) Attention Residuals
附录
一个很经典的问题:LLM embedding 和专门的 text-embedding 模型的 embedding 之间有什么区别?
看起来 text-embedding 模型是 sentence level 的输出,本质上还是 token-level 的 Transformer,但在输出层做了一次池化;它们最主要的区别是训练目标不一致,LLM embedding 是为了建模语言;而 text-embedding 目标是把语义相似的文本在高维空间中拉近,通常用上对比学习. 现代很多工作的 text-embedding 模型(如qwen3-embedding)会基于 LLM 底座做下游任务适配因为可复用强大的语言建模能力.